Comprender una base de datos que no habías visto antes es en ocasiones todo un reto, sobre todo cuando la documentación es escasa o inexistente y debes inferir la lógica del negocio a partir de la introspección. Es ahí cuando cualquier desarrollador pagaría por disponer de un esquema de la base de datos bien documentado y actualizado.
Pero más allá de la fase de diseño o para la comprensión de su estructura, los esquemas de BBDD también resultan de gran utilidad en el día a día del desarrollo y el mantenimiento de aplicaciones.
Detectar relaciones entre tablas, identificar índices redundantes, auditar cambios estructurales o simplemente comunicar decisiones técnicas a otros miembros del equipo son tareas que se simplifican enormemente cuando se dispone de una representación.
Resumen del artículo
- Un esquema de base de datos es el “plano” lógico de una BBDD relacional: tablas, columnas, tipos, claves, índices y relaciones; puede representarse de forma visual (ERD) o textual (DDL/SQL).
- Sirve para modelar datos al inicio y, sobre todo, para mantener una referencia viva que evolucione con migraciones y cambios, facilitando desarrollo, onboarding, revisiones y depuración.
- Hay tres niveles de abstracción: conceptual (dominio y relaciones), lógico (estructura relacional independiente del motor) y físico (implementación concreta y decisiones de rendimiento en un SGBD).
- Un esquema actualizado aporta visibilidad, mejora comunicación, reduce riesgos en cambios, ayuda a detectar problemas de integridad/diseño y es clave para migraciones y optimización del rendimiento.
¿Qué es un esquema de base de datos?
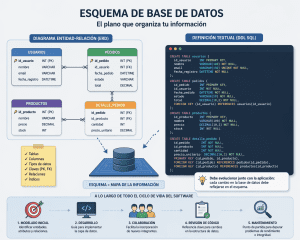
Un esquema de base de datos es una representación formal de la estructura lógica de una base de datos relacional: define las tablas, columnas, tipos de datos, claves primarias y foráneas, índices y las relaciones entre entidades. En esencia, es el plano sobre el que se construye y organiza toda la información que una aplicación gestiona antes de persistirla. Se puede representar de dos formas:
- Visualmente, donde las tablas aparecen como bloques y las relaciones como líneas que las conectan (lo que se conoce habitualmente como diagrama entidad-relación o ERD);
- Textualmente, donde la estructura se describe mediante el lenguaje de definición de datos (DDL) propio del motor de base de datos, con sentencias SQL.
¿Para qué sirve un esquema de BBDD?
Al proceso de crear un esquema de BBDD se le llama modelado de datos, y se realiza normalmente en las fases tempranas del desarrollo de un proyecto, antes de escribir una sola línea de código de una aplicación.
Parte de la identificación de las entidades del dominio (usuarios, productos, pedidos, etc.,), continúa con la definición de sus atributos y culmina con el establecimiento de las relaciones entre ellas, aplicando para ello las reglas de normalización que garantizan la integridad y coherencia de los datos almacenados.
El resultado de este proceso no es solo un documento técnico de referencia, sino una herramienta viva que debería evolucionar junto con la aplicación.
Cada migración, cada nueva tabla añadida, cada columna renombrada o eliminada debería verse reflejada en él, de lo contrario el esquema pierde su utilidad más inmediata: ser un espejo fiel del estado real de la base de datos.
Más allá del modelado inicial, el esquema cumple una función transversal a lo largo de todo el ciclo de vida de software: acompaña al equipo durante el desarrollo, facilita la incorporación de nuevos integrantes, sirve de base para las revisiones de código que afectan a la capa de datos y actúa como punto de partida cuando es necesario depurar un problema de rendimiento o integridad.
Tipos de esquemas de bases de datos
No todos los esquemas de bases de datos responden a la misma necesidad ni se sitúan en el mismo nivel de abstracción. Tradicionalmente se distinguen tres tipos.
Esquema conceptual
Es el más abstracto de los tres. Describe las entidades del dominio y las relaciones entre ellas sin entrar en detalles técnicos ni en la implementación concreta sobre ningún motor de base de datos.
Su objetivo es capturar qué información necesita gestionar el sistema y cómo se relacionan sus elementos, de forma que cualquier persona, independientemente de su perfil técnico, pueda comprenderlo y validarlo.
Es el punto de partida del modelado de datos y el artefacto más adecuado para las conversaciones tempranas con stakeholders no técnicos, ya que abstrae por completo la tecnología subyacente y se centra exclusivamente en la lógica del negocio y sus reglas de dominio.
Esquema lógico
Representa un nivel intermedio entre la abstracción conceptual y la implementación física. Toma las entidades y relaciones definidas en el esquema conceptual y las traduce a estructuras propias del modelo relacional: tablas, columnas, tipos de datos, claves primarias y foráneas, y restricciones de integridad.
A diferencia del esquema conceptual, ya incorpora decisiones sobre cómo se organiza la información en términos relacionales, pero todavía permanece independiente de cualquier motor de base de datos concreto: no especifica si las columnas se almacenan como VARCHAR o TEXT, si los índices son de tipo B-tree o hash, ni si la base de datos es PostgreSQL, MySQL u Oracle.
Su propósito es definir la estructura relacional de forma canónica, sin que las particularidades sintácticas o las capacidades específicas de ningún sistema gestor condicionen las decisiones de diseño.
Esquema físico
Es el más concreto de los tres y el que se corresponde directamente con la implementación real sobre un motor de base de datos específico.
Traduce el esquema lógico a las construcciones propias del sistema gestor elegido: especifica los tipos de datos exactos que ofrece cada motor, define la estrategia de indexación más adecuada, incorpora consideraciones de particionado, tablespaces o motores de almacenamiento, y recoge cualquier otra decisión que dependa de las capacidades y restricciones del sistema gestor.
Es, en definitiva, el esquema que se ejecuta: el que se traduce en sentencias DDL reales, el que determina el comportamiento en producción y el que condiciona directamente el rendimiento, la escalabilidad y la mantenibilidad del sistema a largo plazo.
Esquema de estrellas vs. copos de nieve
Por otro lado, también debemos diferenciar dos patrones de organización propios del ámbito del almacenamiento analítico y la inteligencia de negocio:
- Esquema de estrellas: organiza los datos alrededor de una tabla de hechos con las métricas a analizar (ventas, ingresos, eventos), rodeada de tablas de dimensiones (fechas, productos, clientes, geografías) conectadas directamente por claves foráneas. Destaca por su simplicidad y buen rendimiento en analítica al requerir pocos joins, a cambio de posibles redundancias en las dimensiones al no estar normalizadas.
- Esquema en copo de nieve: es una extensión del esquema en estrella en la que las dimensiones se normalizan y se dividen en tablas jerárquicas para reducir redundancia (por ejemplo, producto → categoría → subcategoría → fabricante). A cambio, aumenta la complejidad y las consultas suelen requerir más joins, con posible impacto negativo en el rendimiento frente al esquema en estrella.
Ventajas de disponer de un esquema de base de datos
- Visibilidad estructural inmediata: permite a cualquier miembro del equipo comprender de un vistazo cómo está organizada la base de datos, qué tablas existen, qué relaciones las vinculan y qué restricciones gobiernan la integridad de los datos Esta visibilidad elimina la fricción habitual en los procesos de incorporación y reduce tiempo que un desarrollador necesita para orientarse en una base de código desconocida.
- Facilidad para detectar problemas de integridad y diseño: permite identificar con relativa facilidad anomalías estructurales que de otro modo pasarían desapercibidas hasta que se manifiestan como errores en producción:
- Soporte para la comunicación técnica entre equipos: un esquema de base de datos actualizado actúa como lenguaje común entre perfiles. Reduce la ambigüedad en las discusiones técnicas, alinea las expectativas sobre el modelo de datos y evita que cada interlocutor trabaje con una imagen mental distinta de la misma realidad.
- Trazabilidad de la evolución estructural: es un registro implícito de las decisiones estructurales que han ido moldeando el modelo de datos. Esta trazabilidad, especialmente cuando el esquema se gestiona junto al código fuente bajo control de versiones, permite reconstruir el razonamiento detrás de cada cambio y entender el estado actual del modelo.
- Reducción del riesgo en los procesos de cambio: cualquier modificación estructural sobre una base de datos en producción entraña un riesgo inherente que va mucho más allá del impacto inmediato de la sentencia ejecutada.Contar con el esquema como referencia antes de ejecutar cualquier cambio permite anticipar el alcance real de la modificación.
- Base para la optimización del rendimiento: el esquema proporciona el contexto estructural necesario para abordar con criterio cualquier proceso de optimización de consultas SQL o de la capa de persistencia. Conocer qué índices existen, cómo se relacionan las tablas y qué volumen de datos maneja cada entidad permite identificar los puntos a optimizar.
Ingeniería inversa de una base de datos
En muchas ocasiones los equipos heredan bases de datos sobre las que no existe documentación alguna: sistemas que llevan años en producción, aplicaciones migradas de un proveedor externo o proyectos en los que el esquema nunca se formalizó porque creció de forma orgánica junto al código.
Cuando esto ocurre, los problemas a la hora de realizar cualquier cambio, migrar la base de datos a la nube o al tratar de optimizar el rendimiento de una consulta crítica, se multiplican: sin una representación clara de la estructura, cada modificación exige una exploración previa del esquema real a través de consultas al catálogo del sistema, una tarea tediosa y propensa a errores.
La ingeniería inversa de una base de datos es la técnica que permite reconstruir ese esquema a partir de una base de datos ya existente, invirtiendo el proceso habitual: en lugar de partir del diseño para llegar a la implementación, se parte de la implementación para reconstruir el diseño.
Los motores de base de datos modernos exponen toda la información estructural necesaria a través de sus catálogos del sistema: tablas de metadatos que describen con precisión cada tabla, columna, tipo de dato, restricción, índice y relación de clave foránea presente en la base de datos en un momento dado.
Herramientas como ER/Studio, ERwin, PowerDesigner o SQL Developer Data Modeler aprovechan esta capacidad de introspección para conectarse directamente al motor, consultar esos catálogos de forma sistemática y generar a partir de ellos una representación del esquema equivalente a la que se habría producido durante la fase de diseño.
Mucho más que un simple esquema
El esquema de base de datos es, en definitiva, uno de los artefactos técnicos con mayor retorno sobre la inversión en el ciclo de vida de cualquier sistema de información: su coste de creación y mantenimiento es marginal comparado con el valor que aporta en términos de visibilidad, reducción de riesgo, facilidad de incorporación y capacidad de respuesta ante cambios.
Ignorarlo o relegarlo a una tarea pendiente que nunca llega a materializarse es una deuda técnica que, como todas las deudas de este tipo, no desaparece sola: se acumula hasta que el coste de recuperarla supera con creces el de haberla abordado desde el principio.
Si tienes problemas con tu base de datos, en Ausum Cloud podemos ayudarte a documentar, auditar y optimizar tu infraestructura de datos. Si quieres saber más sobre cómo abordamos este tipo de proyectos o necesitas un diagnóstico del estado actual de tu base de datos , no dudes en ponerte en contacto con nosotros.
Conclusión
En resumen, tener un esquema de base de datos bien documentado no solo facilita la comprensión de su estructura durante las primeras fases del desarrollo, sino que también es esencial para la optimización, el mantenimiento y la evolución de las aplicaciones. Un esquema actualizado proporciona visibilidad, ayuda a detectar problemas y mejora la comunicación técnica entre los equipos, reduciendo el riesgo de errores durante cambios estructurales. No subestimes el valor de invertir tiempo en crear y mantener un esquema de base de datos; este artefacto puede marcar la diferencia entre un proyecto exitoso y uno lleno de complicaciones técnicas.
Preguntas Frecuentes
- ¿Qué es un esquema de base de datos?
Un esquema de base de datos es una representación formal de la estructura lógica de una base de datos relacional, que incluye tablas, columnas, tipos de datos, claves y relaciones entre entidades. - ¿Cuáles son los tres niveles de abstracción de un esquema de base de datos?
Los tres niveles son: conceptual (enfocado en el dominio y relaciones), lógico (estructura relacional independiente del motor) y físico (implementación específica en un sistema de gestión de bases de datos). - ¿Cómo puede un esquema de base de datos ayudar en el desarrollo y mantenimiento de aplicaciones?
Un esquema actualizado facilita la comprensión de la estructura de la base de datos, la identificación de problemas de integridad, mejora la comunicación entre equipos y optimiza el rendimiento de las consultas. - ¿Por qué es importante que el esquema de base de datos esté actualizado?
Un esquema desactualizado pierde su utilidad como referencia confiable, lo que puede generar problemas de integración y aumentar el riesgo de errores durante las migraciones o cambios estructurales. - ¿Qué es la ingeniería inversa de una base de datos y cuándo se utiliza?
La ingeniería inversa permite reconstruir el esquema de una base de datos existente sin documentación, a través de herramientas que consultan los catálogos de sistema del motor de base de datos. - ¿Qué diferencias existen entre los esquemas de estrella y copo de nieve?
El esquema de estrella organiza los datos alrededor de una tabla de hechos con dimensiones directamente conectadas, mientras que el esquema en copo de nieve normaliza las dimensiones, lo que puede aumentar la complejidad de las consultas.